Replay · Simulado de IA para o Atacadão · Replay · Simulado de IA para o Atacadão
Replay da live de 4 de novembro

Simulado de IA para o Atacadão

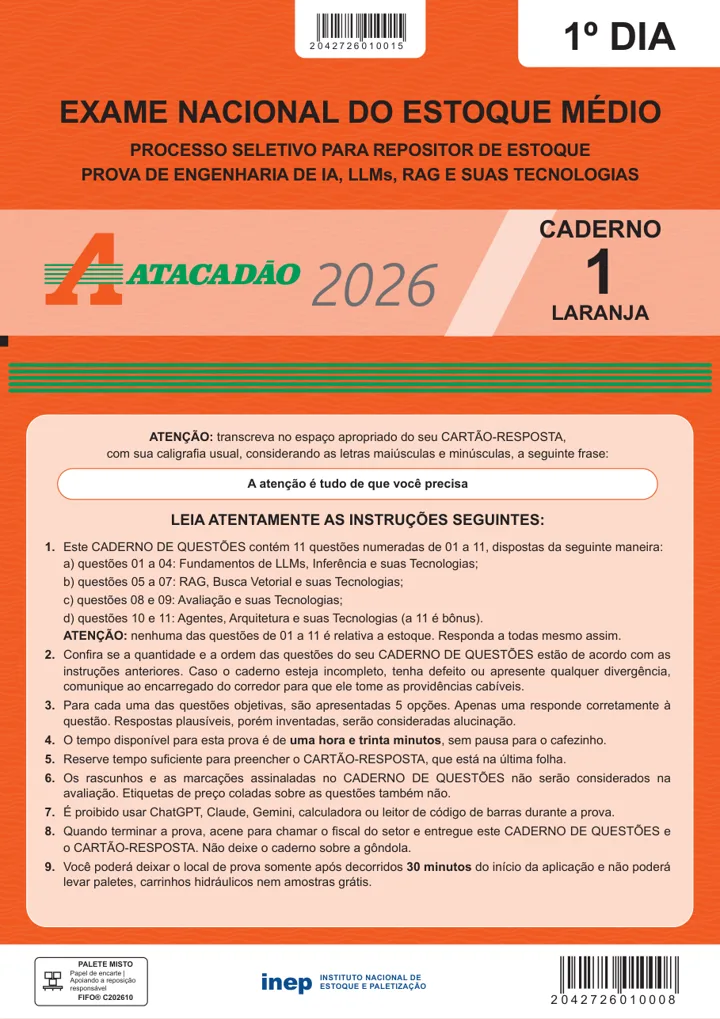
11 perguntas reais de entrevista de IA, das que caem no Google, na NVIDIA e na Microsoft, numa prova pra vaga de repositor de estoque. O hypadinho chuta. O cuiudo sabe o porquê de cada resposta.

Prefere ver no YouTube? Abrir a live no YouTube

Material da live

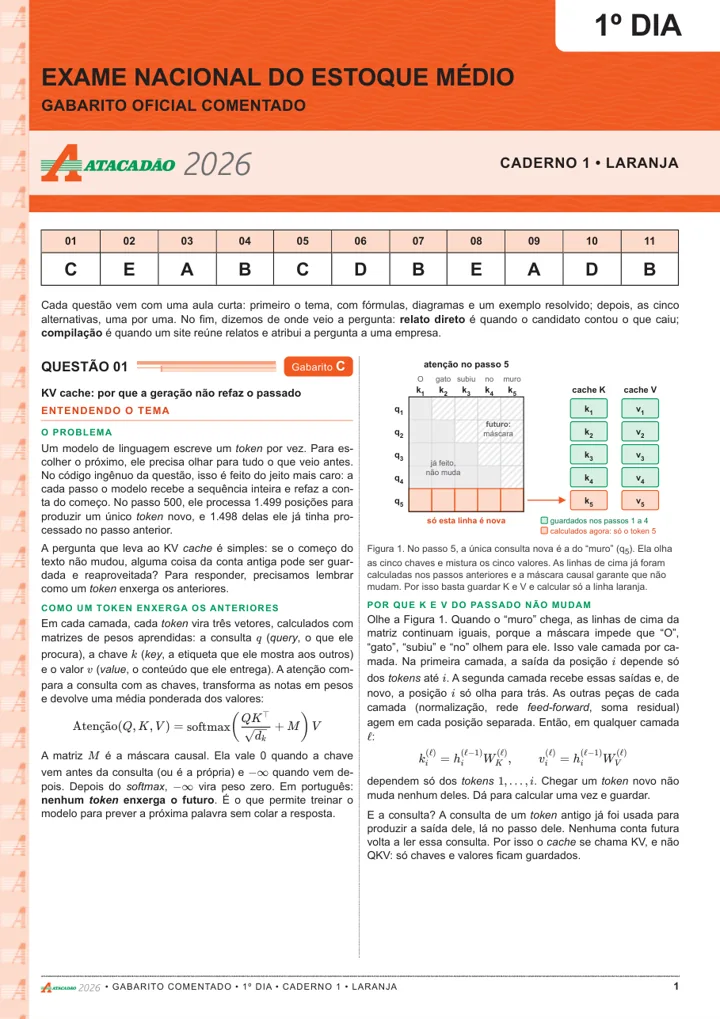
Baixe a prova e o gabarito

Tente resolver antes de olhar o gabarito. Cada questão do gabarito vem com uma aula curta: o tema explicado do zero, um exemplo resolvido e o porquê de cada alternativa estar certa ou errada.

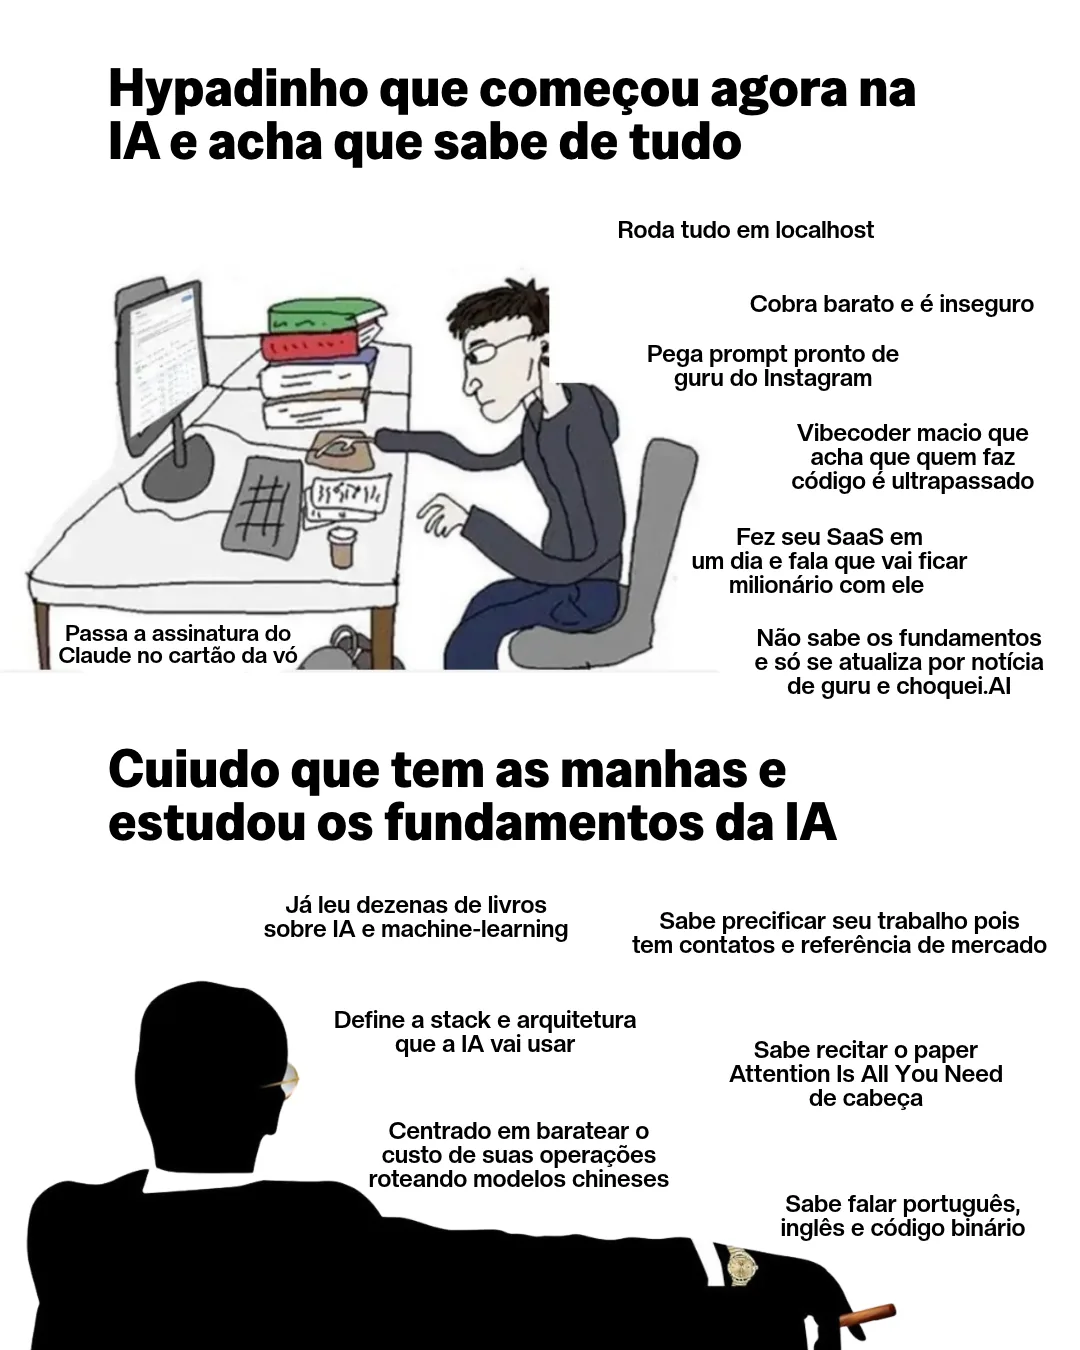
Hypadinho
fazendo a prova
Hypadinho andando
Acha que KV cache
guarda as respostas prontas
Jura que INT4 é rápido
porque a conta em 4 bits é rápida
Põe a hora no começo do prompt
e não entende por que o cache não pega
Confia no juiz
que concorda 96% das vezes
Cuiudo
fazendo a prova
Anwar Hermuche
Sabe que o cache guarda
K e V, e não as respostas
Sabe que o gargalo é ler os pesos
da memória, não fazer a conta
Deixa o que muda no fim
e o prefixo fixo no começo
Olha o que o juiz erra,
não só a taxa de acerto
Teste rápido

Você é hypadinho ou cuiudo?

Esta é a questão 01 da prova. Escolha uma alternativa.

QUESTÃO 01

Um modelo de linguagem gera texto um token por vez. Na implementação ingênua a seguir, a cada passo o modelo recebe a sequência inteira de novo.

tokens = prompt                 # 1.000 tokens
for _ in range(500):
    logits = modelo(tokens)     # sequência inteira
    prox = logits[-1].argmax()
    tokens = tokens + [prox]

Cada token novo demora mais que o anterior. Com o KV cache ligado, o tempo por token cai muito e quase não cresce ao longo do texto.

O KV cache acelera a geração porque

Adaptado de pergunta de entrevista (Google).
O que caiu na prova

11 questões, 4 áreas

Todas adaptadas de perguntas de entrevista de empresas como Google, NVIDIA, Microsoft, Apple, OpenAI e Databricks.

Fundamentos de LLMs e inferência
  1. 01KV cache: por que a geração não refaz o passado
  2. 02Um modelo de 70 bilhões numa GPU de 80 GB: cabe? E quão rápido?
  3. 03Cache de prompt: por que o acerto ficou em 0%
  4. 04Temperatura 0 e não determinismo em servidores de inferência
RAG e busca vetorial
  1. 05LSH: hashes que fazem o parecido colidir
  2. 06Busca híbrida: o embedding entende o sentido, o BM25 lê a palavra exata
  3. 07Reranker: ele reordena os candidatos, não acha os que faltaram
Avaliação
  1. 08Por que o modelo chuta com confiança, e como mudar isso
  2. 09O juiz que concorda 96% e não serve
Agentes e arquitetura
  1. 10Muitas ferramentas: catálogo, busca sob demanda e governança
  2. 11Prompt, RAG ou fine-tuning: fato vai no contexto, comportamento vai nos pesosQuestão bônus
A Primeira Black da DascIA

Quer aprender isso de verdade?

No dia 9 de novembro, às 20h, abre a Primeira Black da DascIA: acesso vitalício a todas as formações, cursos e ferramentas que o Anwar já lançou e ainda vai lançar, com um desconto brutal. 🪖
Entre na lista de interessados para não perder:

E aí, qual dos dois você quer ser?
Hypadinho que começou agora na IA e acha que sabe de tudo versus Cuiudo que tem as manhas e estudou os fundamentos da IA